Le preguntas algo a un chatbot y te contesta con aplomo, pero parte de lo que dice es falso. No es un capricho de la máquina: los propios fabricantes reconocen que sus modelos generan información falsa y explican por qué. Según Google Cloud, las alucinaciones de la IA son «resultados incorrectos o engañosos que generan los modelos».
Repasamos qué entienden por «alucinación» Anthropic, Google y un equipo de OpenAI, por qué ocurre, qué la reduce y qué no la elimina, con su documentación consultada el 9 de octubre de 2026. En nuestro vocabulario básico de la IA explicamos qué son los tokens y la ventana de contexto.
Qué es una «alucinación» para quien fabrica los modelos
La guía de Anthropic para reducir alucinaciones admite que incluso los modelos más avanzados, como Claude, pueden generar texto incorrecto o incoherente con el contexto que se les da. Google Cloud añade que pueden llegar a inventarse enlaces a páginas que nunca existieron.
El artículo «Why Language Models Hallucinate», de tres investigadores de OpenAI y uno de Georgia Tech, habla de «falsedades plausibles y demasiado seguras» y distingue dos tipos: las intrínsecas, que contradicen lo que pide el usuario, como fallar al contar las letras de una palabra, y las extrínsecas, que chocan con los datos de entrenamiento o con la realidad.
El modelo siempre tiene que adivinar
Anthropic lo explica en su investigación sobre cómo razona Claude por dentro: el entrenamiento de un modelo de lenguaje incentiva la alucinación, porque siempre tiene que dar una suposición sobre la siguiente palabra.
El artículo de OpenAI añade que las alucinaciones nacen como simples errores de clasificación: si una afirmación incorrecta no se distingue de un hecho, aparecen por pura presión estadística, aunque los datos de entrenamiento no tuvieran ni un error. El caso típico son los hechos arbitrarios, sin patrón que aprender, como un cumpleaños: preguntado por el de uno de los autores, y con la orden de contestar solo si lo sabía, un modelo abierto puntero dio tres fechas falsas en tres intentos.
Datos de entrenamiento y falta de anclaje
Google Cloud apunta a la materia prima: si los datos de entrenamiento están incompletos, sesgados o tienen fallos, el modelo puede aprender patrones incorrectos. Los autores de OpenAI lo llaman «basura entra, basura sale»: los grandes corpus contienen numerosos errores que el modelo puede repetir.
La otra pata, también para Google Cloud, es la falta de anclaje en el conocimiento del mundo real, que lleva a respuestas plausibles pero incorrectas, irrelevantes o sin sentido. Y está el calendario: la documentación de Gemini presenta la búsqueda como la forma de responder más allá de su fecha de corte de conocimiento.
El freno del «no lo sé» y los exámenes que premian adivinar
Anthropic encontró algo contraintuitivo dentro de Claude: por defecto, un circuito le hace decir que no tiene información suficiente, y una señal de «entidad conocida» lo apaga cuando le preguntan por algo que sí conoce. El problema llega cuando reconoce un nombre pero no sabe nada más de esa persona: la señal salta igual y el modelo fabula una respuesta «plausible, pero por desgracia falsa».
Los autores de OpenAI explican por qué el farol sobrevive al entrenamiento: la mayoría de las evaluaciones puntúa como un examen tipo test, un punto por acierto y cero por dejarla en blanco o decir «no lo sé», así que adivinar siempre sale a cuenta. Un modelo que avisa cuando duda pierde frente a otro que siempre se la juega. Proponen que las pruebas digan cuánta seguridad hace falta para contestar y penalicen los errores.
Qué la reduce, en la documentación de los fabricantes
Anthropic empieza por lo más sencillo: dar permiso al modelo para admitir que no sabe algo, que, asegura, puede reducir drásticamente la información falsa. Con documentos largos recomienda pedirle primero citas literales y trabajar sobre ellas, y que respalde cada afirmación con una cita o la retire.
Su API tiene además una función de citas que devuelve los pasajes exactos que respaldan cada afirmación. Google tira de buscador: anclar Gemini en la Búsqueda de Google sirve para «reducir las alucinaciones del modelo» y mostrar las fuentes. Google DeepMind lo mide con FACTS Grounding, donde una respuesta solo cuenta como precisa si se apoya por completo en el documento dado. Si quieres trastear con un modelo en tu equipo, repasa antes los requisitos para ejecutar un modelo de IA en un PC doméstico.
Lo que no la elimina
Anthropic avisa de que estas técnicas reducen mucho las alucinaciones, pero no las eliminan del todo, y hay que validar siempre la información crítica. Para los autores de OpenAI, ni la búsqueda ni el razonamiento son la panacea: la puntuación binaria sigue premiando adivinar cuando la búsqueda no da una respuesta segura. DeepMind lo resume en una línea: el dominio de los modelos sobre la exactitud de los hechos «sigue siendo imperfecto».
Causas y remedios, de un vistazo
El resumen, con lo que publican Anthropic, Google y el equipo de OpenAI:
| Causa | Qué dice el dueño | Qué la mitiga |
|---|---|---|
| Adivinar la siguiente palabra | El entrenamiento incentiva la alucinación (Anthropic) | Entrenamiento contra la alucinación, eficaz pero imperfecto (Anthropic) |
| Hechos arbitrarios, sin patrón | Errores por pura presión estadística (OpenAI) | Permitir que conteste «no lo sé» (Anthropic) |
| Datos con fallos | Incompletos, sesgados o con errores que el modelo repite (Google Cloud, OpenAI) | Datos relevantes y específicos (Google Cloud) |
| Falta de anclaje | Respuestas plausibles pero incorrectas, hasta enlaces inventados (Google Cloud) | Citas literales, función de citas y búsqueda (Anthropic, Google) |
| Fecha de corte | Hace falta buscar para responder más allá (Google) | Anclaje en la Búsqueda de Google (Google) |
| Evaluaciones binarias | Adivinar puntúa más que decir «no lo sé» (OpenAI) | Pedir un nivel de seguridad y penalizar errores (OpenAI) |
| Freno del «no lo sé» que falla | Reconoce un nombre y responde sin saber (Anthropic) | La investigación no publica un remedio |
Te puede interesar
Tech Planet participa en el programa de afiliados de Amazon. Si compras a través de estos enlaces, recibimos una pequeña comisión sin coste extra para ti, lo que nos ayuda a seguir creando contenido como este.
| Imagen | Producto | Características | Comprar |
|---|---|---|---|
 |
Corsair Vengeance DDR5 64 GB | 64 GB (2 × 32 GB) · DDR5 hasta 6000 MHz · AMD EXPO e Intel XMP 3.0 | Ver precio en Amazon |
 |
GMKtec EVO-X2 AI | AMD Ryzen AI Max+ 395 · 16 núcleos / 32 hilos · 64 GB DDR5 · SSD de 1 TB · 126 TOPS · 2 USB4 | Ver precio en Amazon |
 |
Bosgame M5 | AMD Ryzen AI Max+ 395 · 128 GB LPDDR5X de memoria unificada · SSD de 2 TB · Wi-Fi 7 · 2 USB4 | Ver precio en Amazon |
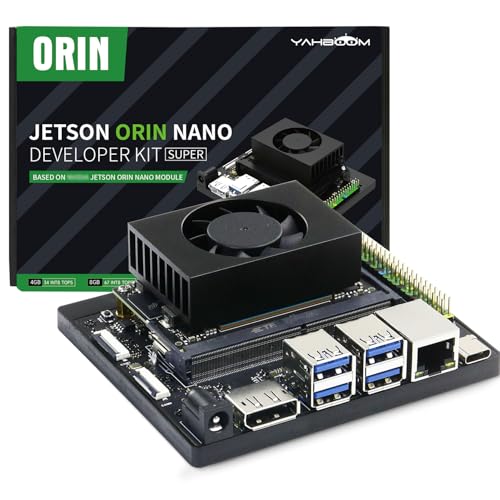 |
Yahboom Jetson Orin Nano Super 8 GB, kit básico | 8 GB · hasta 67 TOPS · SSD de 256 GB · CPU Arm Cortex-A78AE de 6 núcleos · Ethernet de 1000 Mbps | Ver precio en Amazon |