Si alguna vez has ido a bajar un modelo de IA para usarlo en tu PC, te habrás encontrado con etiquetas como q4_K_M, q8_0 o fp16 y con tamaños muy distintos para lo que parece el mismo modelo. La diferencia es la cuantización: guardar los números del modelo con menos bits para que ocupe menos disco y pida menos memoria, a cambio de algo de precisión.
Explicamos qué es un peso, qué hace exactamente la cuantización, qué se gana, qué se pierde y qué significan las etiquetas que ves al descargar, con la documentación de Hugging Face, PyTorch, llama.cpp y Ollama consultada el 29 de octubre de 2026.
Qué es un peso y por qué los bits deciden cuánto ocupa un modelo
Un modelo de lenguaje está hecho de capas, y cada capa guarda sus pesos en un tensor, una gran tabla de números. La guía de conceptos de la plataforma lo explica con un tensor en float32, el formato de coma flotante de 32 bits que toma como estándar, y define la cuantización como la forma de representar esos pesos, y a veces también las activaciones, con tipos de datos de menor precisión, como los enteros de 8 bits, en lugar de float32.
El resumen de cuantización de Transformers completa el cuadro: los pesos se guardan normalmente en precisión completa (fp32), aunque la media precisión (fp16 o bf16) es cada vez más popular por el gran tamaño de los modelos, y algunos métodos bajan aún más, a enteros como int8 o int4.
Importa porque cada parámetro ocupa los bytes de su formato, y en cada pasada el modelo tiene que leer todos y cada uno de sus parámetros. En su artículo sobre cómo aceleraron la generación de texto, el equipo del framework parte de un modelo con cada parámetro guardado en fp16, es decir, 2 bytes por parámetro, y señala que en su caso el mayor cuello de botella es cargar los pesos desde la memoria de la gráfica. El número de parámetros no se puede cambiar, razona, pero sí cuántos bytes ocupa cada uno. De ahí la pregunta que lleva a cuantizar: si cargar los pesos es lo que frena, ¿por qué no hacerlos más pequeños?
El tamaño también crece con el número de parámetros. La ficha de Llama 3.1 en la biblioteca de modelos de la herramienta lo enseña con las tres versiones del modelo: la 8B ocupa 4,9 GB, la 70B, 43 GB, y la 405B, 243 GB. Cuánta memoria tiene tu equipo y cuánta pide cada programa lo contamos en Requisitos para ejecutar un modelo de IA en un PC doméstico.
Qué hace la cuantización: de float32 a enteros de 8 o 4 bits
La idea central, en palabras de la documentación de Transformers, es trasladar el rango de valores de los pesos y activaciones originales en float32 al rango mucho más pequeño que cabe en un int8, normalmente de −128 a 127. Para un tensor concreto, como los pesos de una capa, se buscan su valor mínimo y su valor máximo, y ese tramo se hace corresponder con el rango de los enteros.
El reparto se define con dos parámetros. La escala es un número en float32 que indica la proporción entre el rango original y el de int8, y el punto cero es el entero que corresponde al 0,0 original. Con ellos, cada valor se divide por la escala, se le suma el punto cero y se redondea a un entero; cuando hace falta, se descuantiza para volver a un float32 aproximado. Durante la inferencia, operaciones como la multiplicación de matrices se hacen con los enteros, y el resultado vuelve a float32 antes de pasar a la siguiente capa.
Bajar a 4 bits sigue el mismo principio. Un int4 solo puede representar 16 valores, de −8 a 7 con signo, y reduce el tamaño del modelo y el uso de memoria a la mitad respecto a int8. Como la mayoría del hardware no maneja datos de 4 bits en memoria de forma nativa, lo habitual es empaquetar dos valores int4 en un solo byte para guardarlos y moverlos.
También importa cada cuánto se calculan escala y punto cero. Con un solo juego para todo el tensor, el método es más sencillo, pero menos preciso si los valores varían mucho dentro de él; con uno por canal, grupo o bloque, es más preciso, a cambio de algo más de complejidad y de memoria. El equipo del framework lo cuenta con su propio caso: en int8 usaban un factor de escala por fila y, para ganar precisión, lo cambiaron a uno por cada 32 elementos.
El formato FP8, de coma flotante con 8 bits, conserva la estructura de signo, exponente y mantisa con menos bits y, en ciertos casos, retiene más precisión que int8.
Qué se gana y qué se pierde
La guía de conceptos enumera las ventajas. La primera, el tamaño: un modelo en int8 es más o menos cuatro veces más pequeño que su equivalente en float32. La segunda, la velocidad: las operaciones con tipos de menor precisión, sobre todo con enteros, pueden ser bastante más rápidas en hardware compatible, porque procesadores y gráficas suelen tener instrucciones específicas para int8. La tercera, el consumo: cálculos más rápidos y transferencias de memoria más pequeñas suelen traducirse en menos gasto de energía.
En int4, la ganancia viene sobre todo del ancho de banda. Aunque el hardware no calcule de forma nativa en 4 bits, cargar los pesos empaquetados desde la RAM o la VRAM es más rápido que cargarlos en int8, y en los modelos grandes el acceso a memoria suele ser un cuello de botella importante. El repositorio del proyecto de inferencia en C/C++ resume lo mismo: admite cuantización entera de 1,5, 2, 3, 4, 5, 6 y 8 bits para una inferencia más rápida y un menor uso de memoria.
Lo que se paga es la precisión. La documentación de Transformers lo plantea como un equilibrio entre eficiencia y exactitud: reducir la precisión ahorra recursos, pero introduce inevitablemente pequeños errores, el llamado ruido de cuantización, y el objetivo es que el rendimiento del modelo en su tarea se degrade lo menos posible. Y el error crece al bajar bits: int4 suele provocar una caída de precisión mayor que int8, y para obtener buen resultado en 4 bits a menudo hacen falta técnicas avanzadas como GPTQ o AWQ.
El equipo del framework lo comprobó en sus evaluaciones preliminares con una cuantización solo de pesos, en la que el cálculo sigue haciéndose en bf16: con int8 no apreciaron degradación de la precisión, y con int4, sí. Por debajo de eso, el resumen de Transformers avisa de que algunos métodos necesitan calibración para lograr más precisión con compresiones extremas de 1 o 2 bits.
Cuantizar después del entrenamiento o durante el entrenamiento
La guía de conceptos define dos momentos para hacerlo. La cuantización tras el entrenamiento, PTQ por sus siglas en inglés, se aplica cuando el modelo ya está entrenado del todo.
La cuantización durante el entrenamiento, QAT, simula sus efectos mientras el modelo aprende: inserta operaciones de «cuantización falsa» que imitan los errores de redondeo, de modo que el modelo se adapta a ellos. Suele dar mejor precisión, sobre todo con pocos bits.
Entre los métodos de Transformers también hay diferencias. La guía para elegir método separa los que funcionan al vuelo, más fáciles de usar porque no necesitan un conjunto de datos ni un paso de calibración aparte, de los que exigen calibrar antes con un conjunto de datos para intentar ganar precisión. GPTQ es de estos últimos: según el equipo del framework, usa datos de ejemplo para calibrar los pesos con más exactitud, en lugar de limitarse a redondearlos.
En la práctica, el flujo que describe la plataforma tiene dos caminos: cargar un modelo ya cuantizado desde el Hub o cargar uno en float32, float16 o bfloat16 y aplicarle un método de cuantización. Y la documentación del framework anuncia que está centralizando todo el desarrollo de cuantización en torchao, una biblioteca de tipos de datos y optimizaciones a medida con la que se cuantizan pesos, activaciones y más, tanto para la inferencia como para el entrenamiento.
Qué significan las etiquetas que ves al bajar un modelo
Empecemos por GGUF. La documentación del Hub lo describe como un formato binario optimizado para cargar y guardar modelos rápido, pensado para la inferencia, diseñado para GGML y desarrollado por el mismo autor que el proyecto de C/C++ citado arriba. A diferencia de formatos que solo guardan tensores, como safetensors, un GGUF incluye los tensores y un conjunto estándar de metadatos en un único archivo, y admite muchos tipos de datos cuantizados.
Después viene el tipo de cuantización. La tabla del Hub define F32 como el número de coma flotante de 32 bits de precisión simple, F16 como el de 16 bits de media precisión y BF16 como una versión recortada a 16 bits del de 32. Los tipos acabados en K de 2 a 6 bits trabajan con superbloques de pesos: Q4_K es una cuantización de 4 bits con superbloques de 8 bloques de 32 pesos que sale a 4,5 bits por peso; Q5_K, a 5,5; Q6_K, a 6,5625, y Q2_K, a 2,625. Q8_0 y Q4_0 son cuantizaciones de 8 y 4 bits por redondeo al valor más cercano, en bloques de 32 pesos, que la tabla marca como métodos antiguos y poco usados.
Como un mismo repositorio suele guardar varias cuantizaciones, el nombre del archivo es lo que dice cuál bajas: el ejemplo de la documentación de Transformers es un archivo llamado Qwen3.5-4B-Q4_K_M.gguf.
En la biblioteca de la herramienta, las variantes son etiquetas tras los dos puntos. La lista de etiquetas de Llama 3.1 muestra, para la versión 8B, desde 3,2 GB en q2_K hasta 16 GB en fp16, pasando por 4,0 GB en q3_K_M, 4,7 GB en q4_0, 4,9 GB en q4_K_M, 5,7 GB en q5_K_M, 6,6 GB en q6_K y 8,5 GB en q8_0. La etiqueta llama3.1:8b, la que la ficha marca como «latest», comparte identificador con la q4_K_M, y las dos ocupan 4,9 GB.
Los formatos, de un vistazo
Lo que dicen los dueños de cada precisión y de los tipos más vistos en GGUF:
| Formato | Bits por peso | Qué dice su dueño |
|---|---|---|
| float32 | 32 | El estándar, precisión completa |
| float16 y bfloat16 | 16 | Media precisión, cada vez más usada |
| FP8 | 8 | Más precisión que int8 en ciertos casos; pide hardware específico |
| int8 | 8 | Unas cuatro veces menos que float32 |
| int4 | 4 | La mitad que int8; más pérdida de precisión |
| Q8_0 (GGUF) | 8 | Redondeo al más cercano; método antiguo |
| Q4_K (GGUF) | 4,5 | Superbloques de 8 bloques de 32 pesos |
| Q2_K (GGUF) | 2,625 | Superbloques de 16 bloques de 16 pesos |
Cómo elegir en casa y qué límites tiene
La regla de fondo la da la propia documentación de Transformers: elegir un método adecuado para tu hardware y tu uso. Para eso ofrece un selector que indica, para cada modelo, si cabe en memoria en cada precisión, incluida la caché KV. Y cierra su guía con un consejo que vale para cualquier programa: comprobar siempre la precisión y la velocidad del modelo cuantizado en tu tarea concreta y en tu equipo.
Si el modelo no cabe entero en la gráfica, el proyecto de C/C++ ofrece inferencia híbrida entre procesador y gráfica para acelerar en parte los modelos más grandes que la VRAM disponible.
Los límites también están escritos. El cálculo eficiente en FP8 requiere capacidades de hardware que la plataforma sitúa en gráficas recientes, y sin aceleración nativa sus ventajas pueden no notarse del todo. La tabla de compatibilidad del resumen marca, método a método, si funciona en procesador, en gráficas CUDA o ROCm, en Metal de Apple Silicon o en gráficas Intel, y qué bits admite.
Con GGUF dentro de Transformers, la ruta que mantiene los pesos empaquetados admite Qwen3.5 y Qwen3.5 MoE; las demás arquitecturas pasan por el cargador antiguo, que siempre los descuantiza y devuelve un modelo denso normal. Y la guía de importación de la herramienta avisa de que no cuantiza los modelos GGUF al importarlos: hay que prepararlos y cuantizarlos antes con una herramienta GGUF como llama-quantize.
Otra cosa es que el modelo responda con tus propios documentos: esa técnica la contamos en Qué es RAG y cómo conecta un modelo con documentos propios.
Te puede interesar
Tech Planet participa en el programa de afiliados de Amazon. Si compras a través de estos enlaces, recibimos una pequeña comisión sin coste extra para ti, lo que nos ayuda a seguir creando contenido como este.
| Imagen | Producto | Características | Comprar |
|---|---|---|---|
 |
Corsair Vengeance DDR5 64 GB | 64 GB (2 × 32 GB) · DDR5 hasta 6000 MHz · AMD EXPO e Intel XMP 3.0 | Ver precio en Amazon |
 |
GMKtec EVO-X2 AI | AMD Ryzen AI Max+ 395 · 16 núcleos / 32 hilos · 64 GB DDR5 · SSD de 1 TB · 126 TOPS · 2 USB4 | Ver precio en Amazon |
 |
Minisforum MS-S1 MAX | AMD Ryzen AI Max+ 395 · 16 núcleos / 32 hilos, hasta 5,1 GHz · 128 GB LPDDR5x de memoria unificada · 2 TB de almacenamiento · USB4 V2 · dos puertos 10 GbE · Wi-Fi 7 | Ver precio en Amazon |
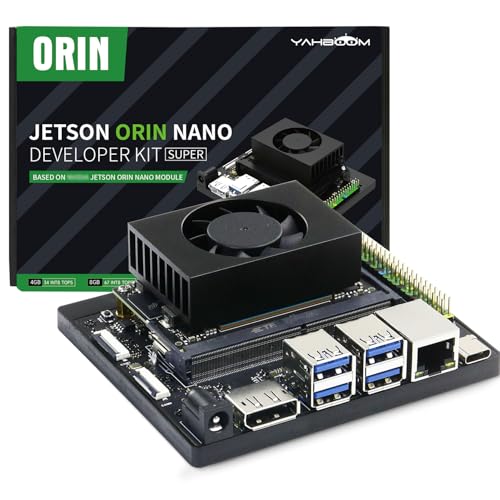 |
Yahboom Jetson Orin Nano Super 8 GB, kit básico | 8 GB · hasta 67 TOPS · SSD de 256 GB · CPU Arm Cortex-A78AE de 6 núcleos · Ethernet de 1000 Mbps | Ver precio en Amazon |