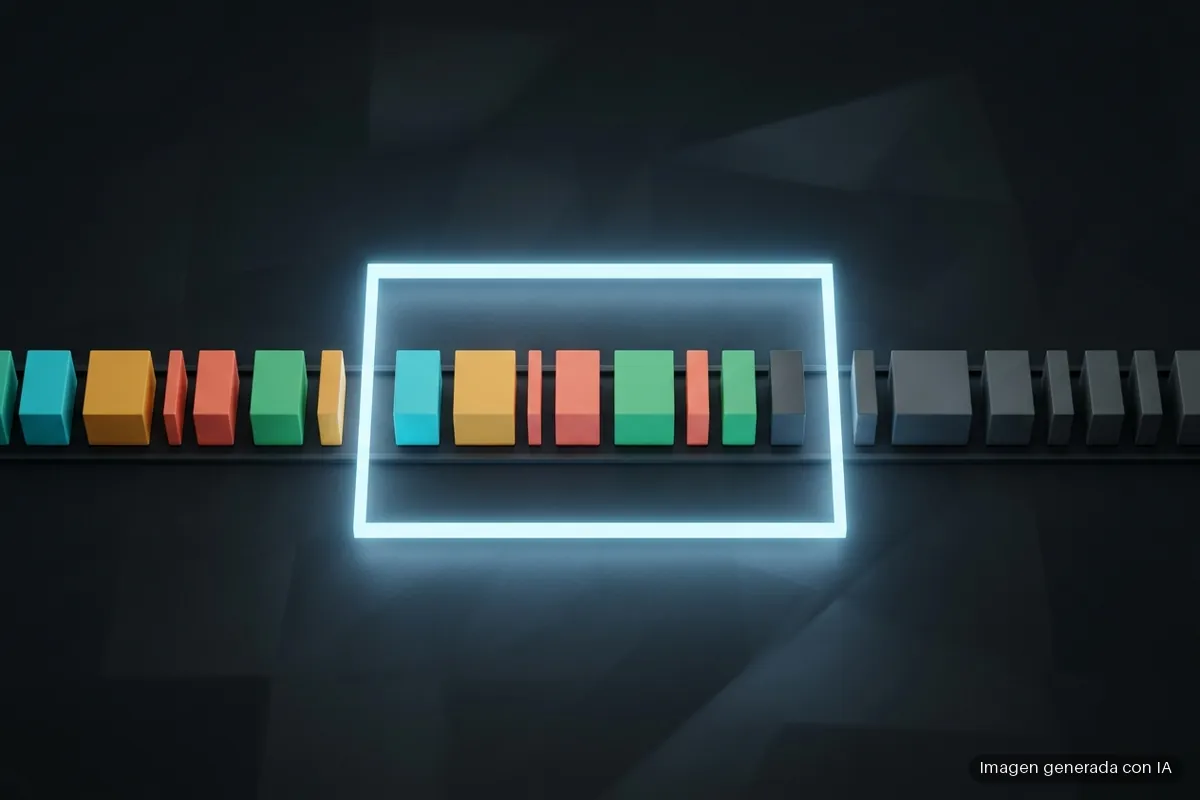
Quien usa un chatbot a diario acaba oyendo dos palabras una y otra vez: tokens y ventana de contexto. El token es la unidad en la que un modelo de lenguaje lee y escribe. La ventana de contexto, como la define la documentación de Anthropic, es todo el texto que el modelo puede tener en cuenta al responder, incluida la propia respuesta: una especie de «memoria de trabajo», distinta de los datos con los que se entrenó.
Repasamos qué es cada cosa, por qué el mismo texto no ocupa lo mismo en todos los modelos, qué pasa cuando la ventana se llena y por qué más contexto no es automáticamente mejor, con la documentación de Anthropic, Google, Microsoft y Hugging Face consultada el 2 de octubre de 2026.
Qué es un token y cuánto texto cabe en uno
Un modelo de lenguaje no lee el texto tal y como lo escribimos. Antes de procesar nada, un tokenizador divide el texto en trozos llamados tokens. La guía de Microsoft sobre tokens explica que esos trozos pueden ser «palabras, juegos de caracteres o combinaciones de palabras y puntuación». El glosario de Anthropic los define como «las unidades individuales más pequeñas de un modelo de lenguaje», que pueden corresponder a palabras, fragmentos de palabras, caracteres o incluso bytes.
La lógica es sencilla: las palabras frecuentes se quedan enteras y las raras se trocean. El curso de Hugging Face sobre tokenizadores lo ilustra en español: «extrañamente» podría tratarse como palabra rara y descomponerse en «extraña» y «mente». La documentación de Gemini añade que el conjunto de tokens que usa un modelo se llama vocabulario, y el proceso de partir el texto, tokenización.
¿Y cuánto texto es un token? Anthropic calcula que, para Claude, un token representa unos 3,5 caracteres en inglés, y avisa de que el número exacto puede cambiar con el idioma. Google da su cuenta para Gemini: alrededor de 4 caracteres por token, y 100 tokens equivalen a entre 60 y 80 palabras en inglés. Ojo a ese «en inglés» que acompaña a la cifra de Claude y a la de palabras de Gemini: están dadas para ese idioma, no para el español.
Y no solo se tokeniza el texto. Google indica que en la API de Gemini pasan a tokens todas las entradas y salidas, imágenes y audio incluidos: una imagen de hasta 384 píxeles por lado cuenta como 258 tokens, y el audio suma 32 tokens por segundo.
El tokenizador: por qué el mismo texto no siempre ocupa lo mismo
Primera trampa: no hay un tokenizador universal. Microsoft explica que el método cambia de un modelo a otro y lo ilustra con una frase corta en inglés: partida por palabras da nueve tokens; partida por caracteres, 34, espacios incluidos.
Hugging Face explica por qué cada modelo necesita el suyo: hay que usar las mismas reglas y el mismo vocabulario con los que se preentrenó. Su guía de tokenizadores de Transformers muestra además que el idioma pesa: las versiones estándar de BPE y Unigram, dos de los tres algoritmos de subpalabras que admite Transformers, dan por hecho que los espacios separan palabras, algo que no sirve para el chino o el japonés, que no los usan; en cambio, dividir en subpalabras resulta especialmente útil en idiomas como el turco, que forma palabras largas encadenando trozos.
Ni siquiera hace falta cambiar de empresa para que la cuenta varíe. En su página sobre el conteo de tokens, Anthropic advierte de que Claude 4.7 y posteriores, además de Claude Mythos Preview, usan un tokenizador más reciente con el que el mismo texto produce aproximadamente un 30 % más de tokens que en los modelos anteriores. Su consejo: volver a contar con el modelo que se vaya a usar en lugar de reutilizar recuentos hechos con modelos anteriores.
Contexto y ventana de contexto
Anthropic detalla qué cuenta dentro de la ventana: las instrucciones del sistema, cada mensaje (con los resultados de herramientas, las imágenes y los documentos), las definiciones de herramientas y también la salida que Claude genera en ese turno, incluido su «pensamiento extendido». Microsoft y Google coinciden en que la ventana suele funcionar como un límite combinado de entrada y salida: lo que escribes y lo que el modelo contesta comparten el mismo espacio.
En una conversación larga con un chatbot eso se nota. Cada mensaje tuyo y cada respuesta del asistente se van acumulando en la ventana, y los turnos anteriores se conservan completos: cada pregunta nueva viaja con todo el historial previo. Un documento largo pegado al principio no ocupa sitio una sola vez; en principio, sigue ahí en los turnos siguientes.
Google lo compara con la memoria a corto plazo: una persona solo puede guardar en ella una cantidad limitada de información, y a los modelos generativos les pasa lo mismo. Para hacerse una idea de la escala, su guía de contexto largo calcula que en un millón de tokens caben 50.000 líneas de código de 80 caracteres, ocho novelas en inglés de longitud media o las transcripciones de más de 200 episodios de pódcast de duración media.
Qué pasa cuando la ventana se llena
Depende de dónde estés. En la API de Claude, si la entrada por sí sola ya supera la ventana del modelo, Anthropic explica que la petición se rechaza con un error 400 en todos los modelos, con el aviso «prompt is too long» (la petición es demasiado larga). Si lo que se pasa es la suma de la entrada y la salida máxima pedida, en Claude 4.5 y posteriores la API acepta la petición y la generación se detiene al llegar al límite de la ventana; en los modelos anteriores, devuelve un error de validación.
En un chatbot la cosa cambia. Anthropic indica que interfaces como claude.ai pueden gestionar la ventana de forma continua con el principio de «primero en entrar, primero en salir». Por eso, en una charla muy larga, puede parecer que el asistente ha olvidado lo que le contaste al principio. Otra vía es la compactación, que resume automáticamente en el servidor las partes antiguas de la conversación para que pueda seguir más allá del límite.
Con ventanas más limitadas, Google cita estrategias como descartar mensajes antiguos, resumir contenido, filtrar instrucciones para ahorrar tokens o usar RAG con bases de datos vectoriales, que el glosario de Anthropic describe como complementar el modelo con una base de conocimiento externa o un conjunto de documentos que se pasa a la ventana de contexto.
Entrada frente a salida máxima
La ventana no es la única cifra que importa. Los modelos tienen también un tope de salida, el máximo de tokens que pueden escribir en una sola respuesta. En la API de Claude es el parámetro «max_tokens», y Anthropic aclara que los tokens de pensamiento forman parte de él, se facturan como tokens de salida y cuentan para los límites de velocidad.
Según la tabla de modelos de Anthropic consultada el 2 de octubre de 2026, Claude Sonnet 5.5 (cuyo lanzamiento ya contamos) tiene una ventana de contexto de un millón de tokens y una salida máxima de 128.000, mientras que Claude Haiku 4.5 se queda en una ventana de 200.000 tokens y una salida de 64.000. Google separa igual las dos cifras: la ficha de Gemini 3.1 Pro en versión preliminar, consultada ese mismo día, da un límite de 1.048.576 tokens de entrada y otro de 65.536 de salida.
Microsoft lo explica con un ejemplo de números redondos: con una ventana máxima de 100 tokens y una entrada de nueve, quedan 91 para la respuesta.
Por qué todo se mide en tokens y cómo contarlos
El token es también la unidad de cuenta. Microsoft explica que los servicios de IA generativa suelen usar precios basados en tokens, que el coste de cada petición depende de los tokens de entrada y de salida, y que entrada y salida pueden tener precios distintos. La documentación de Gemini va en la misma línea: con la facturación activada, lo que cuesta una llamada a la API depende, en parte, de los tokens de entrada y salida. Es la letra pequeña que conviene mirar cada vez que llega un modelo a una API, como GPT-6 Sol.
Microsoft recuerda además que estos servicios limitan el uso con un máximo de tokens por minuto. Y Anthropic añade dos matices: lo que se guarda en la caché de instrucciones sigue ocupando la ventana, porque la caché cambia lo que se paga por esos tokens, no si cuentan; y los recuentos pueden incluir tokens que la propia Anthropic añade para optimizar el sistema, que no se cobran.
Para no ir a ciegas, Anthropic ofrece en su API un conteo de tokens que recibe lo mismo que se enviaría para crear un mensaje y devuelve el total de tokens de entrada antes de mandarlo. Usa el tokenizador del modelo que se le indique, así que sirve para medir el salto entre generaciones del que hablábamos antes, aunque es una estimación: el número real puede diferir en una pequeña cantidad. Google ofrece una llamada equivalente para comprobar el tamaño de la petición antes de enviarla, y después la respuesta desglosa los tokens de entrada, de salida, de pensamiento y el total.
Por qué más ventana no es automáticamente mejor
Con ventanas de un millón de tokens, la tentación es meterlo todo. Anthropic lo advierte sin rodeos: «más contexto no es automáticamente mejor». A medida que crece el número de tokens, la precisión y la capacidad de recuperar información se degradan, un fenómeno conocido como context rot (deterioro del contexto). Por eso, elegir con cuidado lo que entra en el contexto es tan importante como el espacio disponible.
Google matiza en las dos direcciones. Reconoce que, cuando se buscan varios datos concretos a la vez, el modelo no trabaja con la misma exactitud y el rendimiento puede variar mucho en función del contexto. Pero también defiende que, con mucha información y preguntas sobre ella, el modelo es muy capaz de extraerla, con hasta un 99 % de exactitud en muchos casos.
Y deja tres consejos que se entienden bien pensando en ese documento largo pegado en un chatbot: si no hace falta pasarle unos tokens al modelo, mejor no pasarlos; la pregunta funciona mejor al final, después de todo el contexto; y las consultas más largas suelen tardar más en empezar a responder.
El vocabulario, de un vistazo
Para tenerlo a mano, este es el resumen de los términos, con un dato de la documentación oficial para cada uno:
| Término | Qué es | Dato o ejemplo |
|---|---|---|
| Token | Unidad mínima en la que el modelo procesa el texto | Unos 3,5 caracteres en inglés para Claude (Anthropic) |
| Tokenizador | Lo que divide el texto en tokens | «extrañamente» puede quedar en «extraña» y «mente» (Hugging Face) |
| Vocabulario | Conjunto de todos los tokens que usa un modelo | Cada modelo debe usar el de su preentrenamiento (Hugging Face) |
| Ventana de contexto | Todo lo que el modelo puede tener en cuenta al responder, respuesta incluida | Límite combinado de entrada y salida (Google, Microsoft) |
| Salida máxima | Tope de tokens de una sola respuesta («max_tokens» en Claude) | Los tokens de pensamiento cuentan dentro (Anthropic) |
| Conteo de tokens | Cálculo de la entrada antes de enviarla | Es una estimación (Anthropic) |
| Deterioro del contexto | Pérdida de precisión al crecer el contexto | Más contexto no es automáticamente mejor (Anthropic) |
Te puede interesar
Tech Planet participa en el programa de afiliados de Amazon. Si compras a través de estos enlaces, recibimos una pequeña comisión sin coste extra para ti, lo que nos ayuda a seguir creando contenido como este.
| Imagen | Producto | Características | Comprar |
|---|---|---|---|
 |
Corsair Vengeance DDR5 64 GB | 64 GB (2 × 32 GB) · DDR5 hasta 6000 MHz · AMD EXPO e Intel XMP 3.0 | Ver precio en Amazon |
 |
GMKtec EVO-X2 AI | AMD Ryzen AI Max+ 395 · 16 núcleos / 32 hilos · 64 GB DDR5 · SSD de 1 TB · 126 TOPS · 2 USB4 | Ver precio en Amazon |
 |
Minisforum MS-S1 MAX | AMD Ryzen AI Max+ 395 · 16 núcleos / 32 hilos, hasta 5,1 GHz · 128 GB LPDDR5x de memoria unificada · 2 TB de almacenamiento · USB4 V2 · dos puertos 10 GbE · Wi-Fi 7 | Ver precio en Amazon |
 |
Yahboom Jetson Orin Nano Super 8 GB, kit básico | 8 GB · hasta 67 TOPS · SSD de 256 GB · CPU Arm Cortex-A78AE de 6 núcleos · Ethernet de 1000 Mbps | Ver precio en Amazon |