Imagen: Meta
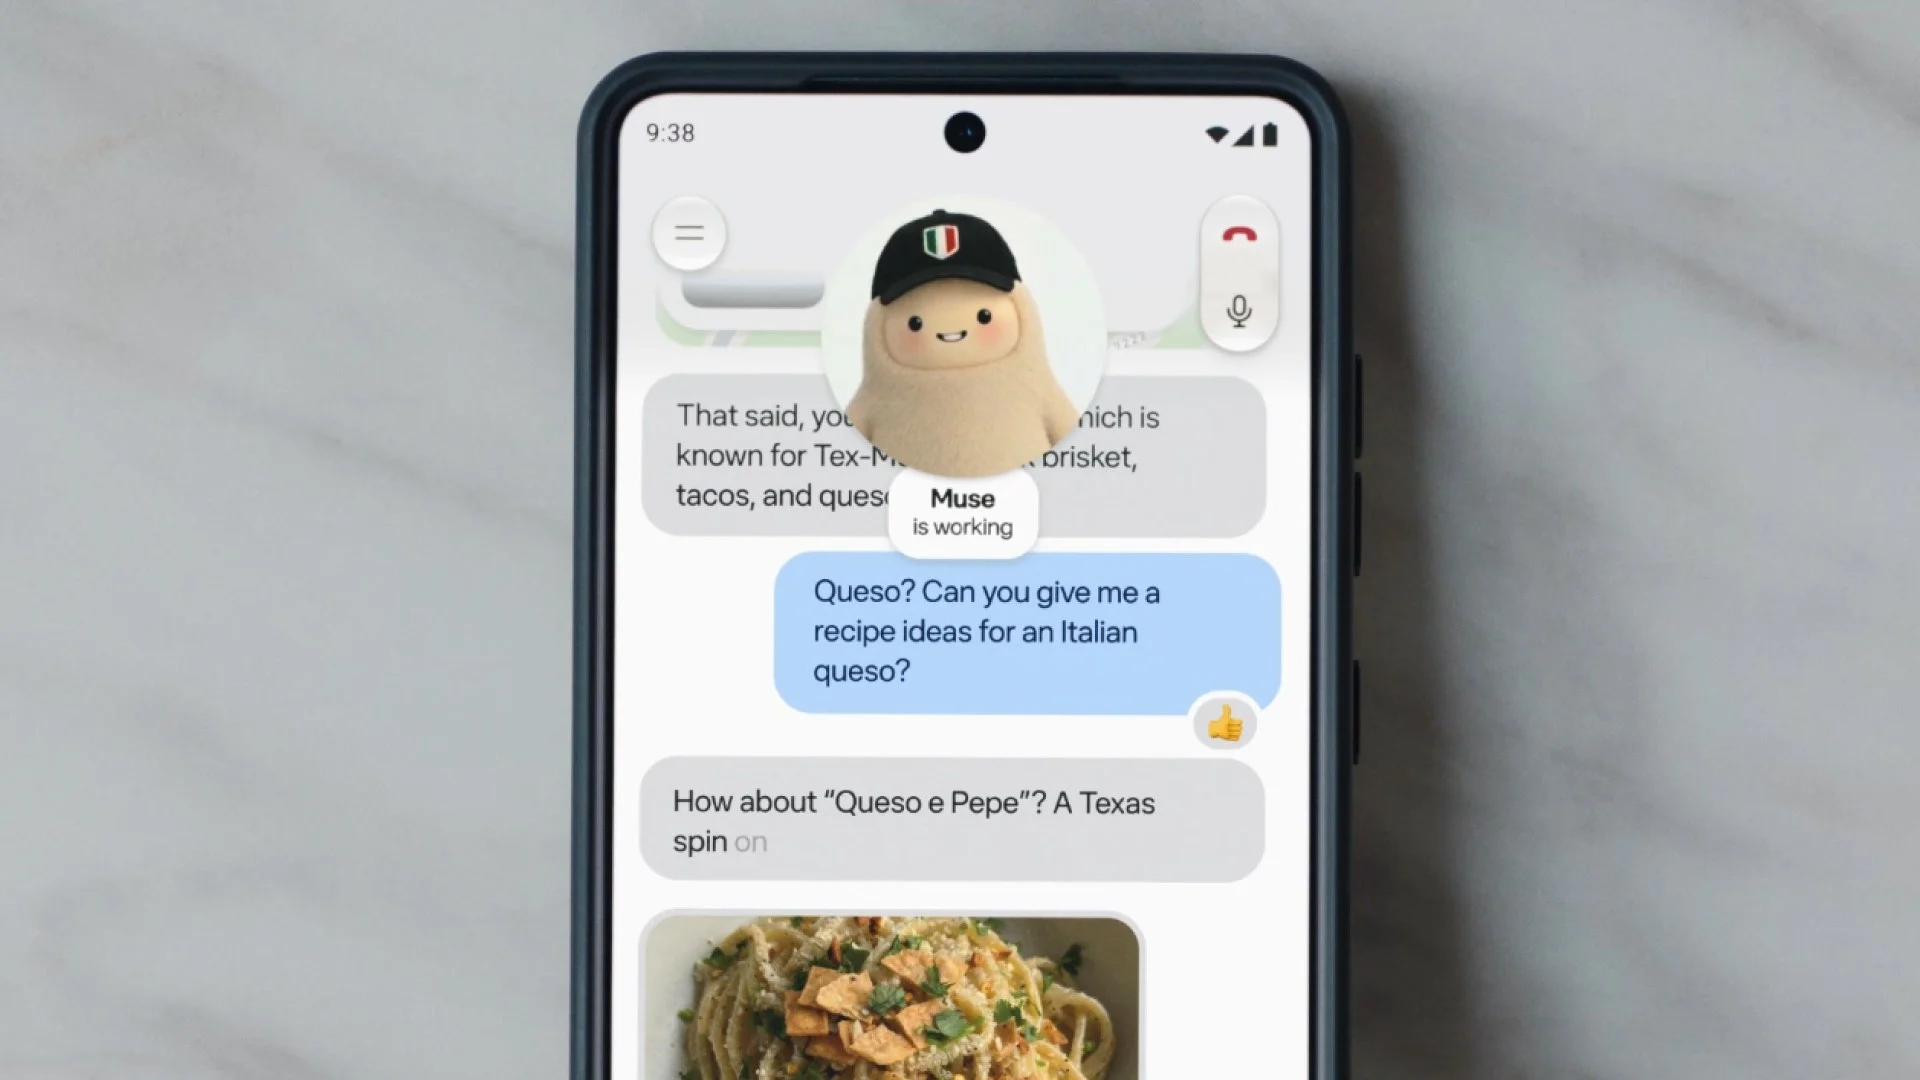
Meta empezó el 5 de noviembre de 2026 a activar la voz y los avatares expresivos en la app Muse, según la nota que publicó en su sala de prensa. La función permite hablar con el asistente de IA en tiempo real, cortarle a mitad de una respuesta y ver cómo un avatar reacciona con gestos mientras escucha y mientras habla. El despliegue arranca en Estados Unidos, en las versiones de la aplicación para móvil, web y Mac.
La compañía ya había enseñado estas conversaciones en tiempo real en Connect 2026, donde también presentó el avatar de Muse, como contamos entonces. Pasa de demostración a función disponible: para empezar a hablar basta con pulsar el icono del teléfono, en la esquina superior derecha de la aplicación.
Pensar en voz alta en lugar de escribir la petición
El argumento de la compañía es que hay cosas que salen mejor habladas que escritas: con la voz se puede ir dando forma a una idea sin preocuparse por redactar la instrucción (prompt) exacta. Su ejemplo es un viaje que empieza con una idea a medias, como la ciudad que uno siempre quiso ver, y Muse recoge el hilo y trabaja mientras la persona sigue hablando.
La empresa también plantea la voz como una forma de ensayar una entrevista de trabajo o una presentación, porque oír una respuesta y contestar sobre la marcha se parece más a la situación real. Y el asistente puede ocuparse de una tarea en segundo plano mientras el usuario va andando o tiene las manos ocupadas.
Un avatar que reacciona mientras escucha
Mientras Muse habla, el avatar hace expresiones y gestos sutiles que acompañan al tono de la conversación, y también reacciona cuando es el usuario quien habla, para que se note que está siguiendo lo que se le dice. Su presencia se elige: solo voz, el avatar al lado de la conversación o a pantalla completa, para hablar cara a cara.
La voz también se personaliza. La empresa habla de cientos de voces entre las que escoger, con ejemplos como la energía de un neoyorquino o el desparpajo de un pirata, y se puede cambiar de estilo cuando se quiera. Las respuestas llegan en el momento y se puede interrumpir al asistente, como a otra persona.
Voz y vídeo salen del mismo flujo
Detrás de la función hay dos tecnologías con nombre propio, Muse Realtime Voice y Muse Realtime Avatar, que el equipo de investigación de la compañía detalló el 23 de septiembre en su blog técnico. La parte de voz genera una secuencia de fichas (tokens) de habla que llevan lo que se dice y la manera de decirlo; un decodificador de audio las convierte en voz, y el avatar se alimenta de la misma secuencia. Compartir ese flujo mantiene sincronizados la voz, los labios y las expresiones.
El avatar es un modelo de difusión de tipo Transformer guiado por el audio, que genera el vídeo en fragmentos cortos y usa lo último generado como contexto para el siguiente, de modo que el personaje conserva su aspecto mientras dure la conversación. Parte de una imagen de referencia: un retrato, una ilustración, un animal o un objeto. Para que vaya en tiempo real, el equipo destiló un modelo maestro que necesitaba 120 evaluaciones por fragmento en un alumno que se queda en dos, 60 veces menos. Estos son los datos de rendimiento que publica:
| Dato | Valor | Qué mide |
|---|---|---|
| Vídeo | 448 × 768, 25 fps | Formato vertical del avatar |
| Latencia | Unos 870 ms | Del fin del turno a la respuesta |
| Generación | 8 fotogramas en 20 ms | Un paso en una GB200 |
| Sesiones | 12 a la vez | Por cada GB200 |
| Evaluaciones | De 120 a 2 | Por fragmento, tras destilar |
Cada paso de 20 ms produce 320 ms de reproducción, y la capacidad se multiplica por ocho frente a la versión base de dos pasos en BF16, con cuantización a cuatro bits y optimizaciones hechas con NVIDIA.
Comparado con Runway y HeyGen, en la prueba de Meta
La compañía comparó su avatar con Runway Characters y HeyGen LiveAvatar, que define como los dos sistemas comerciales de referencia. En su prueba, varios evaluadores mantuvieron conversaciones de dos a tres minutos con cada uno y los compararon en calidad visual, sincronización, coherencia del personaje y gestos, entre otros aspectos. Según la compañía, prefirieron Muse Realtime Avatar en el conjunto y en cada apartado, aunque en los gestos la diferencia con Runway Characters quedó en un empate estadístico.
Marca de agua, solo para mayores de 18 y lo siguiente
El vídeo que genera el avatar lleva una marca de agua invisible y duradera, Meta Video Seal, para que se pueda rastrear su origen, y la empresa asegura que se aplica sin añadir latencia. El blog técnico avisa además de que no todos sus ejemplos reflejan avatares disponibles en la app, y recuerda que Muse es para usuarios de 18 años en adelante.
El siguiente paso ya está anunciado: según la compañía, las conversaciones por voz con Muse llegarán «pronto» a AI Glasses y a Muse Charm.
Te puede interesar
Tech Planet participa en el programa de afiliados de Amazon. Si compras a través de estos enlaces, recibimos una pequeña comisión sin coste extra para ti, lo que nos ayuda a seguir creando contenido como este.
| Imagen | Producto | Características | Comprar |
|---|---|---|---|
 |
Logitech MX Brio Ultra HD 4K | 4K a 30 fps o 1080p a 60 fps · mejora de imagen por IA · dos micrófonos con reducción de ruido | Ver precio en Amazon |
 |
EMEET C960 | Full HD 1080p · dos micrófonos con reducción de ruido · ángulo de visión de 90° · cubierta de privacidad · USB plug and play | Ver precio en Amazon |
 |
RØDE NT-USB+ con cable SC17 | Micrófono USB de condensador · preamplificador Revolution · salida de auriculares con monitorización sin latencia · procesado APHEX · incluye cable SC17 USB-C a USB-C de 1,5 m | Ver precio en Amazon |
 |
Elgato Wave:3 | Cápsula condensadora cardioide · 24 bits y 96 kHz · app Wave Link con hasta siete fuentes · Clipguard | Ver precio en Amazon |
Escrito por Eloy Andrade